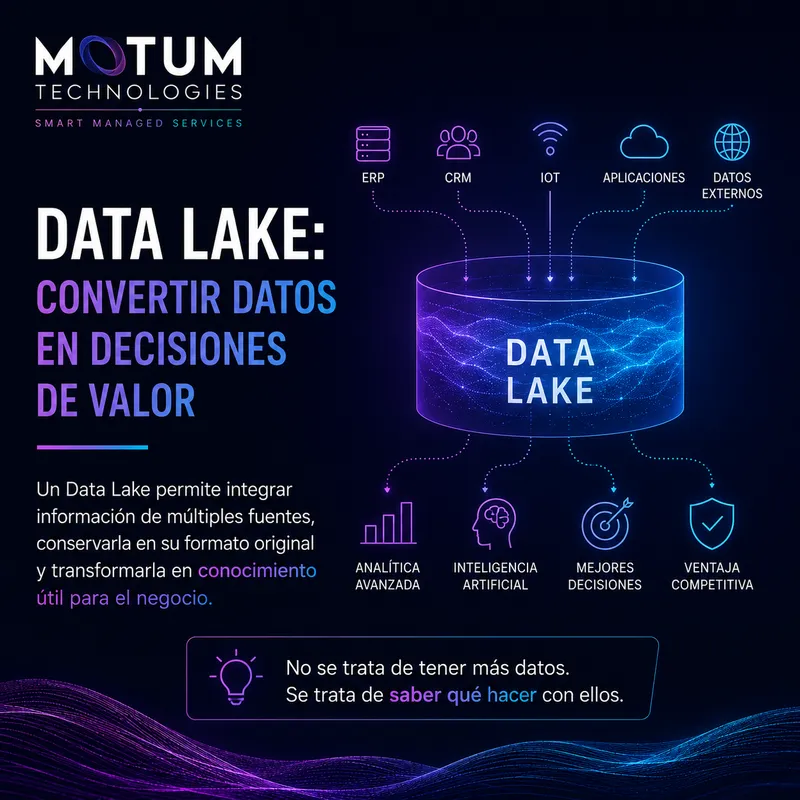
Cada vez que una empresa incorpora una nueva herramienta digital, genera también una nueva fuente de datos. Un ERP registra la actividad financiera, un CRM almacena las relaciones comerciales, una plataforma de comercio electrónico recoge el comportamiento de los clientes, los sensores IoT monitorizan procesos industriales y las aplicaciones corporativas generan miles de eventos cada día. El resultado es un volumen de información que crece de forma constante y que, en teoría, debería ayudar a tomar mejores decisiones.
Sin embargo, la realidad suele ser bastante diferente.
Muchas organizaciones disponen de más datos que nunca, pero tienen dificultades para responder preguntas relativamente sencillas sobre su negocio. La información permanece repartida entre múltiples sistemas, cada departamento trabaja con sus propias herramientas y obtener una visión global exige combinar manualmente datos procedentes de diferentes aplicaciones.
El problema ya no es almacenar información. El verdadero desafío consiste en convertirla en conocimiento.
Es precisamente en ese contexto donde aparece el concepto de Data Lake, una arquitectura pensada para centralizar grandes volúmenes de datos y convertirlos en un activo estratégico para la organización. Pero conviene aclarar una idea desde el principio: implantar un Data Lake no consiste en acumular información indiscriminadamente. Su valor reside en crear las condiciones necesarias para que los datos puedan relacionarse, enriquecerse y transformarse en decisiones de negocio.
Mucho más que un almacén de datos
Cuando se habla de un Data Lake, es habitual pensar en un gran repositorio donde almacenar información. La definición no es incorrecta, pero resulta claramente insuficiente.
La principal diferencia respecto a un Data Warehouse tradicional es que un Data Lake permite conservar los datos en su formato original. No es necesario transformarlos o estructurarlos antes de incorporarlos al sistema, lo que aporta una enorme flexibilidad a la hora de integrar nuevas fuentes de información.
Esto significa que una misma plataforma puede reunir datos procedentes de bases de datos corporativas, archivos JSON o XML, documentos PDF, imágenes, vídeos, registros de sensores industriales o información generada por aplicaciones cloud. Todos ellos conviven dentro de una arquitectura preparada para evolucionar conforme lo hace la empresa.
Esa capacidad de adaptación resulta especialmente valiosa en organizaciones que incorporan nuevas aplicaciones con frecuencia o que trabajan con entornos tecnológicos muy heterogéneos.
No obstante, conviene no perder de vista el objetivo. Un Data Lake no aporta valor simplemente porque almacene más información. Lo hace cuando facilita que esos datos puedan explotarse de forma inteligente.
El verdadero reto no es generar datos, sino conectarlos
En prácticamente cualquier organización moderna conviven decenas de aplicaciones distintas.
Finanzas trabaja con un ERP. El equipo comercial utiliza un CRM. Producción dispone de sus propios sistemas. Marketing analiza campañas digitales mientras recursos humanos emplea herramientas completamente diferentes. A todo ello hay que sumar aplicaciones desarrolladas a medida, plataformas SaaS, soluciones IoT o servicios en la nube.
Cada uno de estos sistemas ofrece una visión parcial de la empresa.
El problema aparece cuando surge la necesidad de responder preguntas que afectan a varias áreas del negocio. ¿Qué campañas generan realmente los clientes más rentables? ¿Cómo influye la logística en la satisfacción del cliente? ¿Qué factores explican el aumento de determinadas incidencias? ¿Qué indicadores permiten anticipar una pérdida de clientes?
Responder a este tipo de cuestiones exige relacionar información procedente de múltiples fuentes.
Un Data Lake nace precisamente para facilitar esa integración.
Al reunir todos esos datos en una arquitectura común, la organización deja de analizar departamentos aislados para empezar a comprender cómo funciona realmente el negocio en su conjunto.
Sin calidad del dato no existe inteligencia empresarial
Existe una idea bastante extendida según la cual implantar un Data Lake resolverá automáticamente los problemas relacionados con la información. Es un error frecuente.
Una arquitectura de datos nunca será mejor que la calidad de la información que recibe.
Si los sistemas contienen registros duplicados, valores inconsistentes, errores de captura o información incompleta, el Data Lake simplemente almacenará esos mismos problemas a mayor escala.
Por eso los proyectos realmente exitosos no empiezan hablando de tecnología. Empiezan hablando de gobierno del dato.
Garantizar que la información sea consistente, identificar el origen de cada registro, normalizar formatos y establecer criterios de validación resulta mucho más importante que decidir qué plataforma tecnológica utilizar.
En el ámbito de la analítica existe una afirmación que sigue siendo completamente vigente: la calidad de las decisiones nunca será superior a la calidad de los datos sobre los que se apoyan.
La importancia de incorporar bien la información
Tan importante como almacenar datos es disponer de un mecanismo fiable para hacerlos llegar hasta el Data Lake.
Este proceso, conocido como ingesta o adquisición de datos, suele pasar desapercibido, pero determina en gran medida el éxito del proyecto.
Cada organización trabaja con una combinación distinta de fuentes de información: aplicaciones empresariales, bases de datos, plataformas cloud, APIs, dispositivos IoT, hojas de cálculo o sistemas desarrollados específicamente para su actividad.
La clave está en conseguir que toda esa información llegue de forma automatizada, manteniendo su contexto y preservando la trazabilidad durante todo el proceso.
Saber cuándo se generó un dato, desde qué sistema procede o qué transformaciones ha experimentado resulta tan importante como el propio contenido.
Sin esa trazabilidad, la confianza en la información termina deteriorándose con el tiempo.
El valor aparece cuando los datos empiezan a conversar entre sí
Existe una frase muy utilizada en proyectos de analítica que resume perfectamente el propósito de un Data Lake: almacenar datos no genera conocimiento.
El verdadero potencial aparece cuando la información puede relacionarse.
Pensemos en una empresa que combina los datos de ventas con la actividad comercial, los tiempos logísticos, las incidencias registradas por atención al cliente y las campañas de marketing.
Cada sistema, por separado, explica únicamente una parte de la realidad.
Cuando toda esa información se analiza de forma conjunta comienzan a aparecer patrones que antes permanecían ocultos. Es posible identificar qué clientes presentan mayor probabilidad de compra, comprender qué procesos generan ineficiencias, descubrir qué productos son realmente más rentables o anticipar riesgos antes de que se conviertan en problemas.
Es precisamente esa capacidad para generar nuevo conocimiento la que convierte un Data Lake en un activo estratégico.
Los datos dejan de describir lo que ha ocurrido para empezar a ayudar a decidir lo que conviene hacer a continuación.
¿Todas las empresas necesitan un Data Lake?
La respuesta corta es no.
Como ocurre con cualquier tecnología, su implantación solo tiene sentido cuando responde a una necesidad real del negocio.
Una pequeña empresa que trabaja con una única aplicación de gestión probablemente obtendrá mejores resultados con soluciones mucho más sencillas.
Sin embargo, el escenario cambia cuando la organización empieza a crecer, incorpora nuevos sistemas o necesita analizar información procedente de diferentes áreas.
También resulta especialmente interesante cuando la empresa quiere desarrollar proyectos de inteligencia artificial, modelos predictivos o analítica avanzada, ya que todas estas iniciativas requieren grandes volúmenes de información histórica y bien organizada.
Más que una cuestión de tamaño, la decisión depende del grado de complejidad de la organización y de la importancia que otorgue a los datos como activo estratégico.
El riesgo de convertir un Data Lake en un Data Swamp
No todos los proyectos alcanzan los resultados esperados.
Uno de los errores más habituales consiste en almacenar información sin establecer criterios de organización, calidad o gobierno.
Cuando esto sucede aparece lo que muchos especialistas denominan un Data Swamp: un enorme repositorio donde existen millones de registros, pero encontrar la información adecuada resulta cada vez más difícil.
Lejos de facilitar el trabajo, el sistema termina convirtiéndose en una fuente adicional de complejidad.
Evitar este escenario exige definir desde el inicio políticas claras sobre calidad del dato, metadatos, catálogos de información, permisos de acceso y procesos de validación.
En otras palabras, un Data Lake necesita tanto orden como capacidad de almacenamiento.
Del dato a la decisión
Existe una tendencia bastante habitual en muchos proyectos tecnológicos: centrar el éxito en la implantación de la herramienta.
Con los Data Lakes ocurre exactamente lo contrario.
El objetivo nunca debería ser construir un repositorio de datos.
El verdadero éxito consiste en conseguir que la información ayude a tomar mejores decisiones.
Cuando los responsables de negocio pueden acceder a datos fiables, relacionar información procedente de distintos departamentos y analizar indicadores prácticamente en tiempo real, la organización gana capacidad para anticiparse a los cambios, detectar oportunidades y responder con mayor rapidez.
En ese momento los datos dejan de ser un subproducto de la actividad diaria para convertirse en una ventaja competitiva.
El papel de Motum Technologies
Construir una estrategia de datos eficaz va mucho más allá de desplegar una plataforma tecnológica. Requiere comprender cómo fluye la información dentro de la organización, integrar sistemas que tradicionalmente han trabajado de forma aislada y garantizar que los datos sean fiables, accesibles y útiles para el negocio.
En Motum Technologies ayudamos a las organizaciones a afrontar ese proceso desde una visión integral. Diseñamos arquitecturas de datos preparadas para crecer, conectamos información procedente de múltiples sistemas, automatizamos los procesos de adquisición y transformación del dato e integramos estas capacidades dentro de una estrategia tecnológica alineada con los objetivos del negocio.
Porque un Data Lake, por sí solo, no transforma una empresa.
Lo que realmente marca la diferencia es la capacidad de convertir los datos en decisiones mejor fundamentadas. Y, en un entorno donde la información se ha convertido en uno de los activos más valiosos de cualquier organización, esa capacidad será cada vez más determinante para competir.
Preguntas frecuentes sobre Data Lake
¿Qué es un Data Lake?
Un Data Lake es una arquitectura de almacenamiento diseñada para centralizar grandes volúmenes de datos procedentes de múltiples fuentes, conservándolos en su formato original. A diferencia de un Data Warehouse, no requiere estructurar la información antes de almacenarla, lo que facilita integrar datos de ERP, CRM, aplicaciones cloud, sensores IoT, bases de datos, documentos o imágenes en un único entorno preparado para su análisis.
¿Para qué sirve un Data Lake?
Un Data Lake permite reunir toda la información de una organización para analizarla de forma conjunta, descubrir patrones, generar conocimiento y facilitar la toma de decisiones basadas en datos. También constituye la base tecnológica para proyectos de Business Intelligence, Inteligencia Artificial, Machine Learning y analítica avanzada.
¿Cuál es la diferencia entre un Data Lake y un Data Warehouse?
La principal diferencia es que un Data Warehouse almacena datos previamente estructurados y transformados, mientras que un Data Lake conserva los datos en bruto o en su formato original. Esto convierte al Data Lake en una solución mucho más flexible para organizaciones que manejan múltiples fuentes de información o grandes volúmenes de datos heterogéneos.
¿Cuándo tiene sentido implantar un Data Lake?
La implantación de un Data Lake resulta especialmente recomendable cuando una empresa trabaja con numerosos sistemas (ERP, CRM, plataformas cloud, IoT o aplicaciones propias), necesita analizar información transversal entre departamentos o quiere desarrollar iniciativas de Inteligencia Artificial, modelos predictivos o analítica avanzada.
¿Todas las empresas necesitan un Data Lake?
No. Las pequeñas organizaciones con pocos sistemas de información pueden resolver sus necesidades mediante soluciones más sencillas. Un Data Lake aporta mayor valor en empresas con procesos complejos, múltiples fuentes de datos o una estrategia orientada a convertir la información en un activo competitivo.
¿Qué tipos de datos puede almacenar un Data Lake?
Un Data Lake puede almacenar prácticamente cualquier tipo de información, incluyendo bases de datos relacionales, archivos CSV, JSON, XML, documentos PDF, imágenes, vídeos, registros de sensores IoT, aplicaciones SaaS, logs, datos industriales e información procedente de servicios cloud.
¿Qué ventajas ofrece un Data Lake frente a mantener los datos separados?
Centralizar la información permite eliminar silos de datos, relacionar información procedente de distintos departamentos, mejorar la calidad del análisis, acelerar la generación de informes y facilitar decisiones más rápidas y fundamentadas. También simplifica futuros proyectos de automatización e Inteligencia Artificial.
¿Qué riesgos existen al implantar un Data Lake?
El principal riesgo consiste en almacenar información sin una estrategia de calidad, organización y gobierno del dato. Cuando esto ocurre, el Data Lake puede convertirse en un Data Swamp, un repositorio desordenado donde encontrar información útil resulta cada vez más difícil.
¿Qué importancia tiene la calidad del dato?
La calidad del dato es uno de los factores más importantes para el éxito de cualquier proyecto analítico. Si los datos contienen errores, duplicidades o inconsistencias, las conclusiones obtenidas también serán poco fiables. Por ello, la gobernanza del dato debe formar parte del proyecto desde el inicio.
¿Qué relación existe entre un Data Lake y la Inteligencia Artificial?
Los modelos de Inteligencia Artificial necesitan grandes cantidades de datos fiables, históricos y bien organizados para entrenarse correctamente. Un Data Lake facilita disponer de esa información centralizada, convirtiéndose en una pieza clave para proyectos de IA generativa, Machine Learning, analítica predictiva y automatización inteligente.
¿Cómo se integran los datos dentro de un Data Lake?
La información llega mediante procesos automáticos de ingesta de datos que conectan aplicaciones empresariales, APIs, bases de datos, sistemas cloud, sensores IoT y otras fuentes de información. Durante este proceso resulta fundamental mantener la trazabilidad y conocer el origen de cada dato para garantizar su fiabilidad.
¿Qué papel puede desempeñar Motum Technologies en un proyecto de Data Lake?
Motum Technologies ayuda a las organizaciones a diseñar arquitecturas de datos escalables, integrar información procedente de múltiples sistemas, automatizar la adquisición y transformación del dato e implantar estrategias que permitan convertir los datos en decisiones de negocio con mayor rapidez y fiabilidad.
Manuel Cantón. Dirección I+D+i en Motum Technologies.